图像压缩对多模态问答下游准确率的影响:两个码率点上的 CPU 基线
固定下游模型 LLaVA-1.5-7B(Q8_0 量化 GGUF,llama.cpp CPU 推理,temperature 0), 在 POPE-random 与 VQA-v2 的同一批图像上,比较传统编码(JPEG / WebP / BPG)与一个经典神经图像压缩模型 (CompressAI 预训练 mbt2018-mean)在 0.25 与 0.5 bpp 两个码率点上的下游准确率。 全部预测、判据与混杂在任何主实验推理之前写死并取指纹(claims.json,核心指纹 97abcabf5c6585a91ce8c26a18f12007da7d1d3d0cc4beb869ddb53f062b37ff)。
0. 结论,以及每句话的适用范围
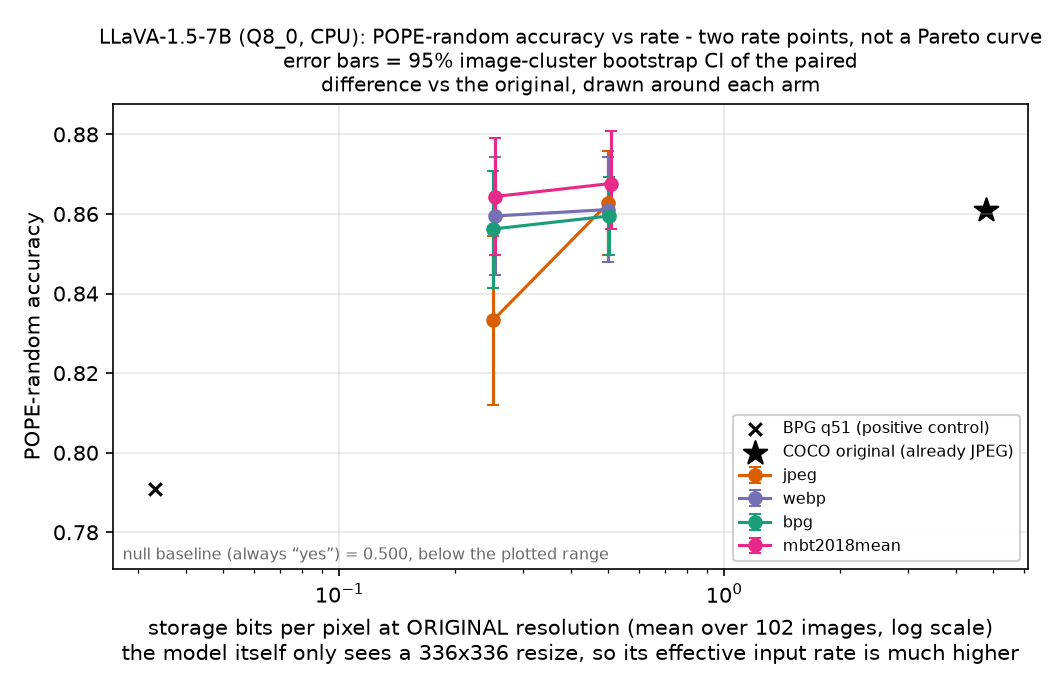
- 在这 102 张 COCO 图上(其中 85 张属 COCO train2017,即 LLaVA-1.5 指令数据的 COCO 图源; POPE 的 yes/no 标签也来自同一批 COCO 物体标注),POPE 上唯一能测出掉点的编码器是 JPEG: 0.25 bpp 掉 2.78 个百分点(95% CI [-4.90, -0.65], p=0.0213)。这是次要比较,不在 5 个主要比较之内,p 也没过 Bonferroni 0.01, 三个图像子集并不一致(Δ 分别 -2.94 / -4.90 / -0.49 点)。 其余三个编码器的 POPE 差异区间都包含 0——这意味着未能检出差异,不等于没有损失。
- 换成开放式问答,同一个码率的代价明显不是"零"。 0.25 bpp 下四个编码器在 VQA-v2 上相对原图全都掉分且区间都不含 0: JPEG 0.7098(-6.26)、BPG 0.7426(-2.99)、 WebP 0.7480(-2.44)、 mbt2018-mean 0.7508(-2.17), 对照原图 0.7725。但跑前写死的直接比较(P6:同一臂上 VQA 掉幅是否大于 POPE 掉幅)在 JPEG 上不可判 (Δ=-3.49 点,CI [-7.43, +0.14]); 把两个任务各自的"可跌空间"归一化后,相对损失几乎一样(POPE 7.69%、VQA 8.11%)。 因此不能写成"开放式问答天生更敏感"。
- 到 0.5 bpp,四个编码器在 POPE 上都不差于原图超过 3 个百分点(预注册的非劣效判据:CI 下界 ≥ −3 点; 实测下界分别 -1.14 / -1.31 / -1.14 / -0.49 点)。 这条非劣效结论只在 POPE 上判过:同一码率下 VQA 点估计仍在下降 (JPEG +0.02、BPG -0.68、 mbt2018-mean -1.29、WebP -1.63 个百分点, 其中 WebP 的区间不含 0)。
口径说明:bpp 一律按原分辨率计算,而 LLaVA-1.5 实际只看 336×336 缩图,送进模型的有效码率远高于标称值; 原图这一臂本身是约 4.785 bpp 的 JPEG,不是无损基线。 本轮设定沿用了评测中常见的"码率-准确率前沿"提法,但只有两个码率点,画不出前沿曲线, 也定不出拐点位置;analysis.json 中的 dominance_screen_* 仅为点估计筛选,不是统计意义上的占优。
1. 这一轮不能支持什么
- 不能给出可与论文直接对照的完整 POPE / VQA-v2 基准分数:本轮是 102 张图、612 道 POPE 题、589 道 VQA 题的子集。
- 不能描述两个码率点之间曲线的形状或拐点位置。
- 不能分辨小于区间半宽的差异:POPE 上"某臂 vs 原图"的 95% 区间半宽为 0.98–2.45 个百分点(中位 1.47), "编码器两两比较"为 1.31–2.53(中位 1.76),VQA 上"某臂 vs 原图"中位 1.94。这是区间宽度,不是功效分析。
- 不能排序 WebP、BPG、mbt2018-mean 三者:彼此差距约 1 个百分点,落在各自区间半宽之内。
- 不能把结论外推到模型没见过的图;本轮也构造不出能核实"没见过"的对照层(见第 4 节)。
- 不能外推到其他下游模型、fp16 原版权重、其他数据集,或面向机器视觉专门训练的编码器; 神经压缩一侧只有一个按 MSE 训练的预训练模型,不能代表这一类方法。
- 没有真正的无损基线:COCO 原图发布时本身已是 JPEG。
2. 预注册预测的判定
判定由分析代码按写死的阈值机械算出(analysis.json 的 verdicts),不是人工判断。
| 预测 | 判定 | 实测 |
|---|---|---|
| P1 完整性(原图 POPE 准确率 ∈ [0.80,0.93],yes/no 格式率 ≥0.98) | supported | 准确率 0.8611,格式率 1.0000 |
| P2 正对照(0.03 bpp 掉 ≥5 点且 p<0.01) | supported | Δ=-7.03 点,CI [-9.48, -4.58],p=2.67e-07 |
| P3 零基线(原图比"全答 yes"高 ≥25 点) | supported | 0.8611 vs 0.5000 |
| P4 主比较(0.25 bpp:mbt2018-mean > JPEG) | supported_by_own_ci_rule_but_fails_bonferroni_0.01 | Δ=+3.10 点,CI [+0.65, +5.56];p=0.0127 未过 Bonferroni 0.01;三个子集 Δ 为 +3.43 / +5.88 / +0.00 点 |
| P4 次要(0.25 bpp:BPG > JPEG) | inconclusive | Δ=+2.29 点,CI [-0.33, +4.74],p=0.0759 |
| P5 高码率非劣(0.5 bpp,只在 POPE 上判)×4 | 四条全部 supported | 下界均 ≥ −1.31 点,远好于 −3 点的非劣效界 |
| P6(0.25 bpp JPEG:VQA 掉幅大于 POPE) | inconclusive | Δ=-3.49 点,CI [-7.43, +0.14] |
P4 的判定字符串本身带着限定:按它自己写死的 CI 判据成立,但没有通过预先声明的多重比较阈值, 且三个子集中有一个效应为 0。方向可信、强度不稳,不能当成"某一类编码器确定更好"。 同码率下另两个对照属探索项:WebP − JPEG Δ=+2.61 点,CI [+0.49, +4.74], p=0.0226。
3. 逐臂结果
POPE n=612 配对题,VQA-v2 n=589 配对题;区间为图级聚类 bootstrap 95% CI(102 图重采样 10000 次)。
| 臂 | 平均 bpp | POPE | Δ vs 原图 | 95% CI | McNemar p | VQA | Δ vs 原图 | 95% CI |
|---|---|---|---|---|---|---|---|---|
| orig | 4.785 | 0.8611 | — | — | — | 0.7725 | — | — |
| bpg_q51 | 0.033 | 0.7908 | -7.03 | [-9.48, -4.58] | 2.67e-07 | 0.6676 | -10.49 | [-14.78, -6.69] |
| jpeg_t1 | 0.251 | 0.8333 | -2.78 | [-4.90, -0.65] | 0.0213 | 0.7098 | -6.26 | [-9.46, -3.53] |
| webp_t1 | 0.253 | 0.8595 | -0.16 | [-1.63, +1.31] | 1 | 0.7480 | -2.44 | [-4.39, -0.51] |
| bpg_t1 | 0.251 | 0.8562 | -0.49 | [-1.96, +0.98] | 0.664 | 0.7426 | -2.99 | [-5.29, -1.02] |
| mbt2018mean_t1 | 0.254 | 0.8644 | +0.33 | [-1.14, +1.80] | 0.824 | 0.7508 | -2.17 | [-4.19, -0.30] |
| jpeg_t2 | 0.500 | 0.8627 | +0.16 | [-1.14, +1.47] | 1 | 0.7727 | +0.02 | [-1.69, +1.80] |
| webp_t2 | 0.500 | 0.8611 | +0.00 | [-1.31, +1.31] | 1 | 0.7562 | -1.63 | [-3.33, -0.14] |
| bpg_t2 | 0.500 | 0.8595 | -0.16 | [-1.14, +0.82] | 1 | 0.7657 | -0.68 | [-2.05, +0.67] |
| mbt2018mean_t2 | 0.507 | 0.8676 | +0.65 | [-0.49, +1.96] | 0.388 | 0.7596 | -1.29 | [-2.99, +0.14] |
码率对齐:同一目标下各臂平均 bpp 相差不超过 1.5%(相对 JPEG 的比值 0.998–1.015)。 逐图并非严格相等:JPEG 有 2 张图在质量 1 仍高于 0.25 bpp;mbt2018-mean 只有 8 个预训练质量档,颗粒最粗。 0.5 bpp 档存在码率不对称:mbt2018mean_t2 的中位码率 0.522 bpp, 比其他编码器高约 4%(相对 JPEG 均值之比 1.015), T1 上匹配良好(1.011)。
4. 事后描述性分析:测试图与训练图源的重叠
跑完之后补做,不改变任何预注册判定。LLaVA-1.5 的指令数据从 COCO train2017 取图;本轮 102 张测试图取自 COCO val2014, 实测 85 张落在 train2017、17 张落在 val2017,两边都不在的 0 张。
命名限制:两层准确的名字只是"属 COCO train2017"与"不属 COCO train2017"。后者不能称为模型没见过的图: LLaVA-1.5 的训练混合还包含 Visual Genome / GQA / TextCaps 等图源,Visual Genome 与 COCO 两个划分都有重叠, 且本轮没有把这 17 张与实际训练图片清单逐一核对。这一层本身不能用来判断训练重叠有没有影响。
| 臂 | 任务 | 属 train2017(85 张) | 不属 train2017(17 张) | 两层之差 |
|---|---|---|---|---|
| jpeg_t1 | POPE | -2.16 [-4.51, +0.20] | -5.88 [-10.78, -1.96] | +3.73 [-0.98, +9.41] |
| jpeg_t1 | VQA-v2 | -5.48 [-8.92, -2.53] | -11.41 [-19.74, -4.79] | +5.93 [-1.48, +14.52] |
| webp_t1 | VQA-v2 | -1.94 [-4.03, +0.02] | -5.77 [-11.18, -0.62] | +3.83 [-1.83, +9.59] |
| bpg_t1 | VQA-v2 | -3.05 [-5.72, -0.91] | -2.56 [-6.89, +1.14] | -0.49 [-5.23, +4.26] |
| mbt2018mean_t1 | VQA-v2 | -1.55 [-3.69, +0.39] | -6.28 [-11.12, -1.15] | +4.74 [-0.83, +9.87] |
| mbt2018mean_t2 | VQA-v2 | -1.00 [-2.83, +0.60] | -3.21 [-7.50, -0.18] | +2.21 [-1.27, +6.75] |
| bpg_q51 | POPE | -7.06 [-9.80, -4.12] | -6.86 [-10.78, -2.94] | -0.20 [-4.90, +4.71] |
在属 train2017 的图上得到的两条结论——"0.25 bpp 下非 JPEG 编码器未检出损失"与"0.5 bpp 在 POPE 上非劣于原图"—— 在另外 17 张上都不再成立,八个编码器臂的点估计都大出约一倍以上。但这不是一个结论,有四条反面限制:
- 该层只有 17 张图(POPE 102 题、VQA 78 题),区间很宽; 两层之差本身并不显著(上表最后一列的区间几乎都包含 0)。
- 极端对照只在 POPE 上不跟着走:bpg_q51 在 POPE 上两层几乎一样 (-7.06 对 -6.86 点); 但它在 VQA 上两层差距很大(-8.98 对 -20.38 点), 方向与其他臂一致。这条反面证据只成立于 POPE。
- 两层难度本来就不同,且方向相反:原图在不属 train2017 的 17 张上 POPE 反而更高 (0.9118 对 0.8510),VQA 则相反 (0.7577 对 0.7748)。没有按难度或基线配对。
- 没有交互项检验、没有功效分析,两层规模 85 对 17 极不平衡。
因此本轮既不能确认、也不能排除训练重叠在其中的作用。
5. 掉点落在哪一侧(描述性,非假设检验)
POPE 真值严格 50/50。模型在原图上就偏向回答 "no":只有 37.1% 的题答 yes, gt=yes 侧准确率 0.7320,gt=no 侧 0.9902。
预注册里 E1 被命名为"幻觉方向偏移",这个名字不成立(预注册已锁,只能就地更正):实测是 召回率下降(0.7320 → 0.6046)、 精确率几乎不变(0.9868 → 0.9635)。 可以说的是漏检增加可检出;不能说幻觉没有增加——POPE 假阳性本来就极少 (原图 3 道 → bpg_q51 7 道),计数太小, 幻觉方向有没有变化本轮判断不了,两个方向都不能断言。
6. 运行与复核
10 个臂 × 1201 道题 = 12010 次推理,全部 temperature 0 确定性解码,纯 CPU 单实例 3 线程, 墙钟约 28.86 小时(约 86.6 核时)。循环顺序为 臂→图→该图全部问题,使每张压缩图只做一次图像预填 (实测每张新图首题 63.25 秒,同图追问 3.36 秒)。
运行中途因人为误操作导致推理服务被中止一次;驱动按重试逻辑恢复服务,把受影响的那张图整张重算后跑完全部 1020 个图×臂。事后复核:12010 行、每臂恰好 1201 行、重复 0、同键冲突 0、缺失 0、空答案 0。
主分析(numpy)与独立复算(纯标准库、独立实现的打分代码)在所有臂的 POPE 准确率、VQA 准确率、 平均 bpp 与 McNemar p 上完全一致;重跑分析产出的结果文件逐字节相同。
7. 数据与权重
全部匿名直连可下载,无需注册或数据使用协议:COCO val2014 图片、POPE 标注(MIT)、VQA-v2 val 标注(CC BY 4.0)、 LLaVA-1.5-7B 的 GGUF 权重(Llama 2 许可)、CompressAI 预训练 mbt2018-mean、libbpg 0.9.8。 逐条状态码、体积与校验值记录在 source_audit.json 与 work/data/selection.json。 POPE 标注取自仓库 main 分支,该文件最后修改提交为 edebdda36a96;复现建议用固定 commit 并核对 sha256。
figs/ 目录。随附材料(点开即看,不用下载)
- REPORT.md本页的 markdown 原文
- 00_download_data.sh实验代码 00_download_data.sh
- 01_select_data.py实验代码 01_select_data.py
- 02_make_variants.py实验代码 02_make_variants.py
- 03_run_vlm.py实验代码 03_run_vlm.py
- 04_analyze.py实验代码 04_analyze.py
- 05_recheck.py实验代码 05_recheck.py
- 06_figs.py实验代码 06_figs.py
- 07_manifest.py实验代码 07_manifest.py
- 08_posthoc_seen_split.py实验代码 08_posthoc_seen_split.py
- 09_public_md.py实验代码 09_public_md.py
- run_all.sh实验代码 run_all.sh
- fig.png主结果图
← 全部案例 · JouleBeat · DeepGraph