山东沿海 7 市旅游强度与近岸海域水质的残差交互分析:公开数据撑不起这个问题
问题:旅游业指标在控制经济社会变量后,对近岸海域水质的净影响方向。 落成的口径:山东省 7 个沿海城市(青岛、烟台、威海、潍坊、日照、东营、滨州)2021–2023; 自变量 = 旅游接待人次 / 旅游收入;控制变量 = 常住人口 + 第二产业增加值(含年份固定效应); 目标变量 = 近岸海域优良(一、二类)水质比例。 这一轮真跑了:数据采集 → 逐条回原文核对 → 残差交互分析 → 零模型 5000 次 × 3 个种子 × 两种置换方案 → 按城市整块重抽 2000 次 × 3 个种子 → 留一城市 → 正负对照与检出率模拟。 纯 CPU,七个步骤合计约 14 秒机时;时间几乎全花在找数据上。
0. 结论
三句话:
- 这个问题在公开数据上现在做不成。 21 个「城市 × 年份」格子里,五项数据同时齐全的 只有 10 个;按跑之前写死的口径一致性规则,能进主分析的只剩 3 个。 主分析因此没有跑——不是结果不好看,是样本量不够到无法成立。
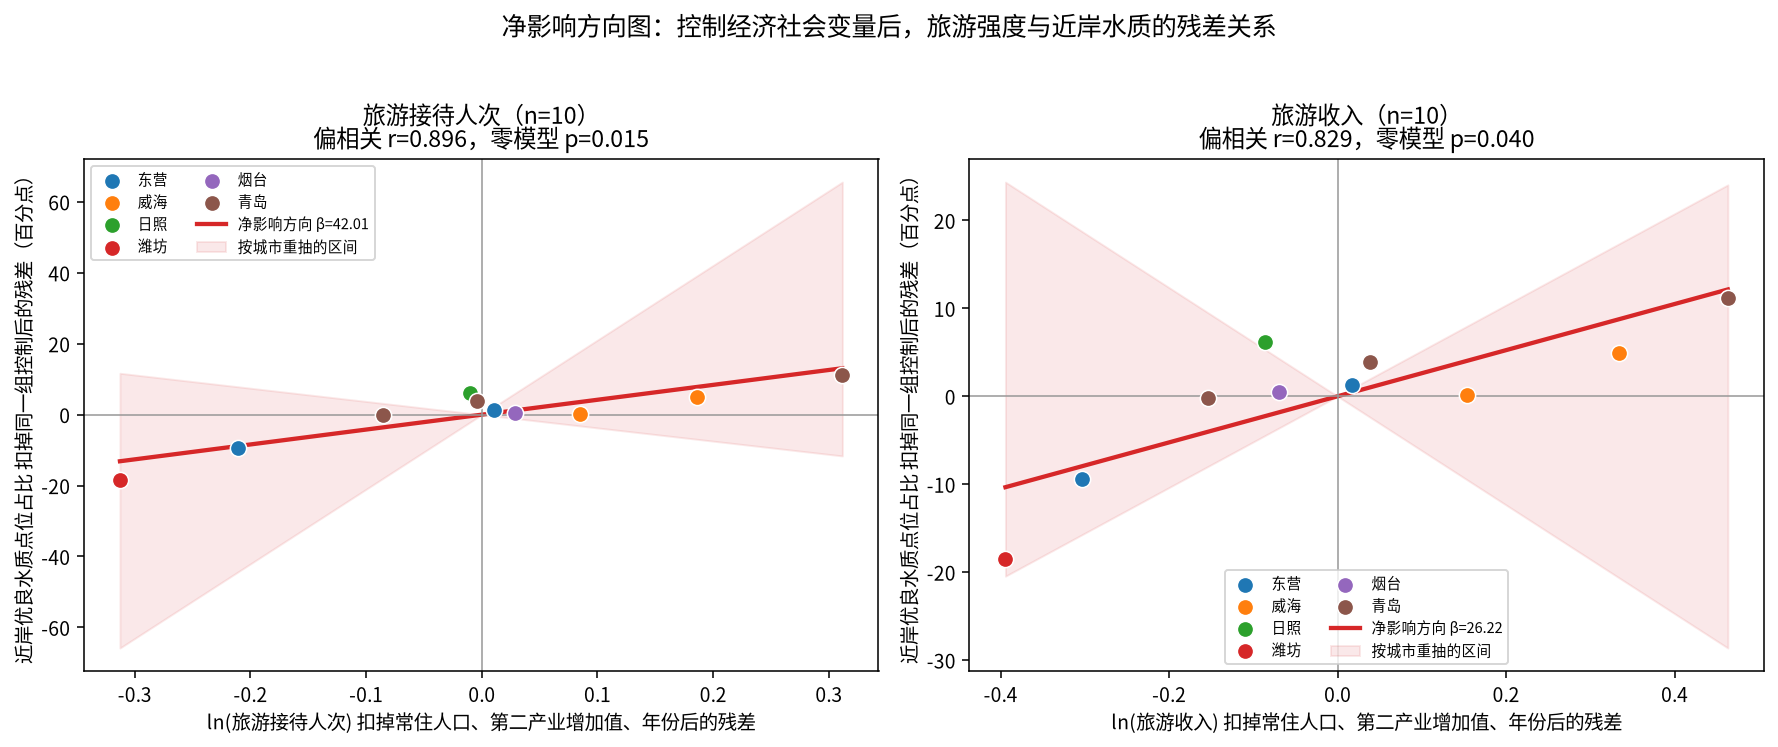
- 把口径规则放宽到预注册里事先写好的敏感性口径(10 个观测全进)——以下只是方向性提示,因为目标变量混用了两种口径:威海是点位法,青岛、烟台、东营是面积法,潍坊、日照原文未写明——点估计是正的,但方向没有被钉住(按预注册 P2「区间跨 0 就不做方向性宣称」记为方向不定): 旅游接待人次每翻一倍,近岸优良水质比例高 29.1 个百分点(偏相关 0.896, 零模型 p = 0.015 / 0.016 / 0.013,三个种子一致)。
- 但这个数字不能读成「旅游改善了水质」,方向恰恰相反于待检验的污染假说,而且它几乎 全部来自城市之间的差异:城市之间的水质差距有 10.5 个百分点(标准差),而同一座城市 三年里的水质波动只有 0.48 个百分点——同期这些城市的旅游人次在自己内部有近一倍的变化。 也就是说,这条关联说的是「旅游大市恰好是水质好的那几个市」(青岛、威海、日照面向黄海, 潍坊、东营、滨州在渤海/莱州湾一侧),不是「旅游涨了、水质跟着变」。
这一轮跑之前写下的预测(P1:在这个样本量上测不出任何关联)被推翻了,两种零模型方案 都给出 p < 0.05、三个种子一致。我们按预注册如实报告这个推翻。但同一份预注册里的 另一条判据也触发了:按城市重抽的偏相关 95% 区间横跨 −1.00 到 1.00,方向并没有被钉住。 p 值和区间说的不是一回事,两个都得看。
1. 卡住这一轮的不是方法,是数据
7 个城市 × 3 年 = 21 个格子。逐格找下来:
| 字段 | 拿到 | 缺哪些 |
|---|---|---|
| 年末常住人口 | 21/21 | — |
| 第二产业增加值 | 20/21 | 威海 2023 |
| 近岸海域优良水质比例 | 14/21 | 烟台 2022/2023、潍坊 2022、日照 2021/2022、东营 2022、滨州 2022 |
| 旅游接待人次 | 15/21 | 滨州三年全缺、潍坊 2021/2022、威海 2023 |
| 旅游收入 | 15/21 | 同上 |
五项同时齐全的只有 10 个:青岛 2021/2022/2023、烟台 2021、威海 2021/2022、 潍坊 2023、日照 2023、东营 2021/2023。
几个具体的坑,都是这类研究会反复撞上的:
- 滨州三年的统计公报根本不发旅游数据,全文搜「接待 / 游客 / 旅游收入」零命中。 潍坊 2021/2022 只有定性描述(「新评定 4A 级景区 1 家」),没有人次和金额。
- 烟台从 2022 年起把近岸海域这一项从统计公报里拿掉了。2021 年那句 「符合一、二类海水水质标准的海域面积占全市管辖海域面积的 94.9%」在 2022/2023 两版里整句消失; 我们交叉查了市统计局版和市政府门户版两个独立版本,都没有。
- 东营 2022 只有分航次值(春季航次 32.9%、秋季航次 73.3%),没有年度值。 按跑之前定的规则,不许拿单航次冒充年度数,这一格判为缺失。
- 山东省级的《生态环境状况公报》三年都取不到可解析文本:2021 年那份是纯扫描件 (22.6 MB / 28 页,无文字层),2022/2023 两份源站不可达、存档快照被截断。 《中国海洋生态环境状况公报》2021–2023 三份我们都完整下载了(17–147 MB), 但正文同样是图片,没有文字层。这是本轮最值得下次先解决的一件事: 省级公报里有全部 7 市的统一口径数据,只要能把它转成文本,样本量能从 10 涨到 21。
2. 口径不统一:为什么预注册的主分析没能跑
跑之前写死的规则是:同一个城市在进入分析的那些年份里,指标口径必须一致;不一致的, 该城市该指标按缺失处理,另做一次把它们加回来的敏感性分析,两个结果都报。
对上真实数据之后:
- 旅游口径在 2022 年集体切换。 多数市从「接待国内外游客」或不分内外的「接待游客总人数」 切成「接待国内游客」。青岛、威海、东营三市都在三年里跨了口径 —— 按规则,它们的旅游数据 在主分析里全部作废。
- 剩下口径自洽的只有烟台 2021、潍坊 2023、日照 2023 三个观测。n = 3,主分析无法进行, 代码按预注册的下限(n < 8 跳过)直接跳过,日志在
work/logs/analyze_strict.log。
这个口径差到底有多大,我们量了: 威海 2021 年公报同一段里同时给了三套数 —— 接待旅游总人数 4407.3 万人次、接待国内游客 4403.93 万人次、接待入境游客 3.37 万人次。 入境占比 0.076%;旅游总收入与国内旅游收入在公报里是同一个数(都是 533.52 亿元)。 我们又把 20 份公报正文全量扫了「入境 / 境外 / 外汇收入」,只有威海 2021 这一处单列入境, 其余 19 份零命中。2021–2023 这三年边境基本关闭,两种口径差在千分之一量级。
所以敏感性分析(10 个观测全进)在数值上是可信的,本报告后面的数字都出自它。 但口径规则本身没有放宽、也没有回头改预注册,两条路径的结果都在包里: work/results/analysis_strict.json(n=3,跳过)与 work/results/analysis.json(n=10)。
目标变量这一侧的口径更麻烦,而且没法用同样的办法化解:
| 口径 | 城市 |
|---|---|
| 点位法(国控点位优良率) | 威海 2021/2022/2023 |
| 面积法(优良水质面积比例) | 青岛 2021/2022/2023、烟台 2021、潍坊 2021、东营 2021/2023、滨州 2021 |
| 原文未写明点位还是面积 | 潍坊 2023、日照 2023、滨州 2023 |
预注册里对这种情况的处置是:主结论降级为仅方向性提示,并点名是哪几个城市。 本报告照此执行。这也是为什么第 0 节说「方向性提示」而不是「结论」。
3. 结果:数字、方向,以及它到底在说什么
10 个观测,6 个城市,扣掉常数、两个控制变量与两个年份哑变量后,残差自由度 4。
| 旅游接待人次 | 旅游收入 | |
|---|---|---|
| 偏相关 r | 0.896 | 0.829 |
| 每翻一倍对应的水质变化 | +29.1 个百分点 | +18.2 个百分点 |
| 零模型(置换旅游指标)p,三个种子 | 0.0148 / 0.0156 / 0.0130 | 0.0404 / 0.0350 / 0.0346 |
| 第二种零模型(Freedman–Lane)p | 0.0010 / 0.0006 / 0.0006 | 0.0032 / 0.0028 / 0.0036 |
| 比只有控制变量的平凡基线多解释 | ΔR² = 0.486 | ΔR² = 0.416 |
| 按城市重抽的偏相关 95% 区间(种子 0) | [−1.00, 1.00] | [−1.00, 1.00] |
| 重抽里方向为负的比例 | 10.5% | 9.9% |
「3 个种子方向一致」这句话旁边必须放着那个区间——这是跑之前就写进判据的要求。 p 值说:假如这 10 行彼此独立,这个方向和随机打乱能分开。但这 10 行只来自 6 个城市、水质几乎只在城市之间变;复核补做的模拟显示,在同样的城市聚集结构下、旅游与水质毫无关系时,这个检验有约 14% 的概率给出 p<0.05(名义 5%),改成按城市整块置换则 p=0.50。所以 p=0.015 不能当作「信号和随机能分开」的证据。区间说:只有 6 个城市可抽, 换一组城市,方向可能整个翻过来(约十分之一的重抽确实翻了)。两句都是真的,别只引一句。
为什么不能读成「旅游改善水质」,第 0 节那个 0.48 是关键:
| 城市 | 年份 | 水质(%) | 城市内部波动 | 旅游人次最大/最小 |
|---|---|---|---|---|
| 青岛 | 2021/2022/2023 | 99.0 / 99.0 / 99.3 | 0.14 个百分点 | 1.98 倍 |
| 威海 | 2021/2022 | 100 / 100 | 0 | 1.24 倍 |
| 东营 | 2021/2023 | 76.1 / 78.7 | 1.30 个百分点 | 1.37 倍 |
同一座城市三年里旅游人次能差一倍,水质几乎不动;而城市之间的水质差距有 10.5 个百分点 (青岛 99、威海 100,对潍坊 43.8–75.6、东营 76–79)。这条关联住在城市之间,不住在城市内部。 城市之间的差别里,最不像旅游造成的那一条是地理:青岛、威海、日照面向黄海开阔海域, 潍坊、东营、滨州在渤海/莱州湾一侧,本身就是半封闭海湾、受入海河流总氮影响大。 旅游体量也沿着同一条线分布。这种情况下,正向系数最自然的解释是反向因果加地理混杂 ——水好所以旅游旺,不是旅游旺所以水好。 我们在预注册里就把反向因果列为已声明混杂, 这一轮的数据规模不足以把它拆开。
本来能拆开它的是城市固定效应(只看城市内部的变化)。10 个观测、6 个城市, 加上城市哑变量之后自由度归零,这条路在本轮样本量下走不通,代码如实记为 insufficient_df,没有硬跑一个没有自由度的模型出来。
4. 这把尺子测得准吗(正负对照与检出率)
跑之前写死的作废开关:正对照测不出、或负对照虚警超过 10%,主结论一并作废。
- 负对照(因变量换成纯噪声,真实偏相关 = 0):三个种子 p = 0.277 / 0.149 / 0.788, 一个都没虚报;另做的 200 次模拟里,零效应档的虚警率 7%(95% 区间约 4%–11%),接近名义的 5%。但这些模拟用的都是互相独立的噪声;换成与本面板一样「城市之间差很多、城市内部几乎不动」的噪声,同一个检验的虚警率约 14%(复核补做,1000 次)。这把尺子只验证了独立数据的情形,替这份面板的 p 值背不了书。
- 正对照(注入真实偏相关 0.6 的合成因变量):三个种子 p = 0.195 / 0.004 / 0.010, 3 个里测出来 2 个。刚好达到预注册的门槛(至少 2 个),但也正好暴露了问题——
检出率曲线(n = 10,200 次模拟 × 每次 399 次置换):
| 真实偏相关 | 0.0 | 0.2 | 0.4 | 0.6 | 0.8 |
|---|---|---|---|---|---|
| 被测出来的比例 | 7% | 6% | 22% | 40% | 86% |
在这个样本量上,真实偏相关得达到 0.8 才有八成把握看得见。 反过来说: 这一轮观测到的 0.896 之所以被检出,正是因为它大得离谱——而一个大到 0.9 的偏相关, 在只有 6 个城市、且城市之间本身就按地理分成两组的情况下,更像是分组效应,不是净效应。
5. 留一城市
去掉任意一个城市重算,旅游接待人次的偏相关仍在 0.786–0.986,方向没有被单个城市带着走。 但旅游收入那一侧不同:去掉东营之后偏相关从 0.829 掉到 0.159,说明收入口径那条结论 对单个城市敏感得多。两条都在 work/results/analysis.json 的 loco 段里。
6. 这一轮不能支持什么
- 不能支持任何因果说法。10 个观测、没有外生冲击、没有工具变量、城市固定效应跑不了。
- 不能支持「旅游对近岸水质有正面影响」。正号几乎全部来自城市之间的地理差异。
- 不能支持「旅游对近岸水质没有负面影响」。真实负效应要达到 0.8 量级才有八成把握被看见, 更小的负效应在这个样本量下本来就看不见。
- 不能支持任何政策建议(限流、收费、排污管控)。
- 不能推广到山东以外,也不能推广到 2021–2023 以外。这三年旅游受疫情压制、口径还切了一次。
- 不能把不同口径的水质数字当成同一把尺子——点位法、面积法、未写明三种混在同一列里。
7. 数据从哪来,每个数字怎么查
- 85 条原始记录全部随包交付在
work/data/data_provenance.json,每条都带: 城市、年份、指标原文、数值、单位、实际下载到的 URL、随包交付的来源文件、 以及那句话的原文片段。 - 来源文件本身在
work/data/sources/(36 份,1.1 MB),可以直接打开核。 audit_delivery.py会把面板里的每一个数字回到来源文件里重新 grep 一遍,对不上就报错。- 来源强弱我们没有抹平:威海、烟台、青岛、日照的多数记录来自
.gov.cn原文 (青岛 2021 那份是官方统计公报 PDF,本机连不上官网,经服务端抓取取回); 潍坊、滨州、东营的水质数字来自第三方统计公报转载库(tjgb.hongheiku.com、etmoc.com), 数字已在本地文件里核到原文,但没能与官方原始页面二次比对。 每条记录的source_type字段都标了这一点。如果这批数据要进正式研究,这 6 条建议复核。
8. 怎么复现
``bash python3 work/code/00_assemble_provenance.py # 回原文核对 85 条记录 python3 work/code/01_build_panel.py # 生成 panel.csv 与 panel_strict.csv python3 work/code/02_analyze.py panel.csv analysis.json # 主分析(需 numpy) python3 work/code/02_analyze.py panel_strict.csv analysis_strict.json python3 work/code/03_recheck.py panel.csv recheck.json # 独立复算(纯标准库) python3 work/code/05_diagnostics.py # 城市内 / 城市间分解 python3 work/code/04_figs.py # 出图(需 matplotlib) python3 audit_delivery.py # 包内自检,只用标准库 ``
全部随机性由显式种子控制(置换、重抽、对照噪声一律走标准库 random.Random(seed)), 同机重跑逐位一致。主分析走 numpy,独立复算是另写的纯标准库实现,两者在 β、偏相关、ΔR²、 三个种子的置换 p、重抽区间、正负对照 p 上逐项对齐到 1e-8 以内。 说明白一点:两条实现共用同一套抽样与数值规范(同一 PRNG、同一 Gram–Schmidt 秩容差), 所以它抓的是公式与索引错误,不是数值库之间的差异。
figs/ 目录。随附材料(点开即看,不用下载)
- results.json原始结果。报告里每个数字都能在这里查到
- plan.json事先写下的实验计划与那个可被推翻的预测(预注册)
- REPORT.md本页的 markdown 原文
- 00_assemble_provenance.py实验代码 00_assemble_provenance.py
- 01_build_panel.py实验代码 01_build_panel.py
- 02_analyze.py实验代码 02_analyze.py
- 03_recheck.py实验代码 03_recheck.py
- 04_figs.py实验代码 04_figs.py
- 05_diagnostics.py实验代码 05_diagnostics.py
- fig.png主结果图
← 全部案例 · JouleBeat · DeepGraph