真实时变社交图上的离线强化学习去极化基准
数据集:SNAP Reddit Hyperlink Network(Kumar et al., WWW 2018) 算力:纯 CPU 单机,约 6 分钟机时,全程无 GPU
0. 先说结论
在这张真实的 Reddit 时变交互图上,离线强化学习没能打过平凡启发式,而且输得很干净。
在 12 个留出评估种子上,离线 RL(Fitted Q Iteration)相对「不干预」把留出期末的极化方差降低了 15.87%(中位数),而一个只挑「当前意见最极端的节点」的单步贪心启发式降低了 34.99%。 两者预算完全相同(96 次节点扰动)。12 个种子无一例外,贪心都更低: 配对差值中位数 −0.02508,配对 Wilcoxon 符号秩双侧精确 p = 0.00049,rank-biserial = −1.00。 换成全程 AUC 口径,结论不变(同样 0/12,p = 0.00049,rank-biserial = −1.00)。
预注册的 H1 假设是「离线 RL 会更好」。H1 被推翻。
这不是尺子坏了。跑之前就预注册的两项尺子对照都通过了:
- 正对照(方向已知的差距):同一启发式预算翻倍,尺子测出来了 —— 12/12,p = 0.00049。
- 负对照(不该有差距的地方):两个独立随机策略互比,尺子没有虚报 —— p = 0.73。
而且所有干预臂都确实打得过「什么都不做」这个零模型(每一个都 12/12,p = 0.00049), 说明这套环境与指标是能测出干预效果的 —— 它只是同时告诉我们,离线 RL 在这个设定里 拿到的那部分效果,明显少于一行贪心代码。
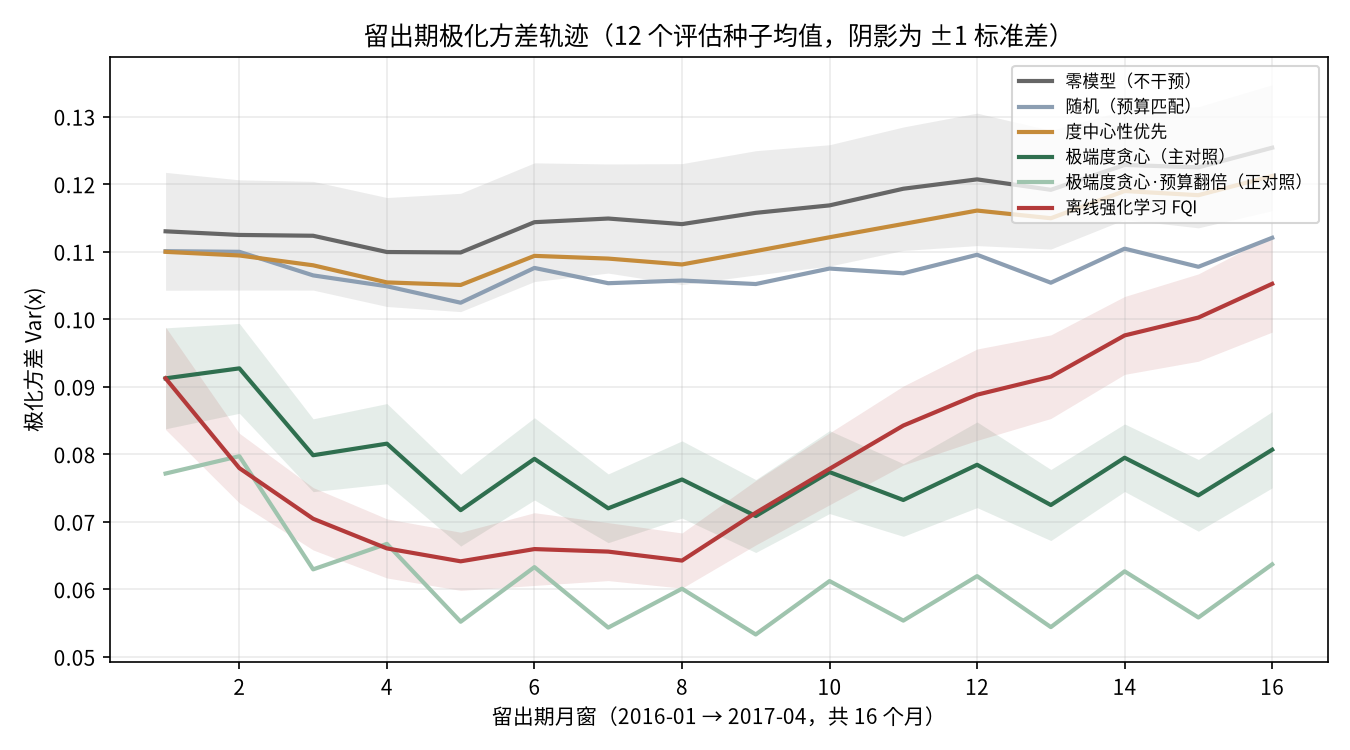
为什么输,我们查到了具体位置(下面第 5 节,事后探索):不是节点挑错了,是钱花错了时候。 离线 RL 与贪心选中的节点有 81.8% 重合,两者出手的月份数也完全一样(都是 8 个月), 但离线 RL 把 96 次预算连续压在留出期的前 8 个月,后 8 个月一次都没出手;贪心是隔月出手、 摊满 16 个月。前 8 个月里离线 RL 其实赢(12/12 种子上极化更低),后 8 个月扰动随锚定衰减、 方差反弹,12/12 种子上输回去,终点和全程两个口径都输。
这一轮不能支持的推断
- 不能说「Reddit 上的真实极化被降低了 X%」。这张图是真的 —— 拓扑、每条交互的真实时刻、 每条交互是否敌意,都来自数据集原始字段。但节点的「意见」数值是模拟的:该数据集不含任何 节点观点标签,我们也实测确认没法从它的符号结构里诚实地提取一条立场轴(见第 2 节)。 本轮的极化是在真实图上按明确写死的规则演化出来的受控量,不是真实人群的真实观点。
- 不能说「离线 RL 做不了去极化」。本轮只证伪了一个具体组合:这个数据集、这个扰动算子、 这个预算结构、这个 FQI 实现。换算子或换预算结构,结论可能反过来(第 7 节给了方向)。
- 不能把输的原因单独归给「离线 RL 这个方法」。训练日志来自 2014-01..2015-12,评估在 2016-01..2017-04,Reddit 这段时间自身在变,分布漂移与方法本身在本轮拆不开。
- 不能外推到更大规模。本轮 247 个节点、44623 条边。
- 不做多数据集 benchmark,不做超参搜索 —— 超参是跑前锁定的那一组,只跑过这一组。
1. 这一轮的问题设定
在公开的真实时变社交交互图上,评估离线强化学习在节点级扰动下能把极化方差降低多少,并给出策略轨迹。
| 设定要素 | 本轮做的 | 在哪 |
|---|---|---|
| 公开时变社交网络交互数据集 | SNAP Reddit Hyperlink Network,286562 条带秒级时间戳的真实超链接,匿名可直连下载 | 第 2 节 |
| 极化话题子图 | 取「关联敌意边最多」的 250 个 subreddit 的冲突核,共 247 个节点、44623 条边、18.0% 为敌意边 | 第 2 节 |
| 离线强化学习 | Fitted Q Iteration + ExtraTrees,日志一次采完即冻结,训练期间零环境交互 | 第 3 节 |
| 节点级扰动 | 每窗最多扰动 12 个节点(4.86% ≤ 5%),x ← 0.5·x | 第 3 节 |
| 极化方差降低幅度 | 逐臂给出 | 第 4 节 |
| 策略轨迹 | 出手时机、每窗规模、被扰动节点清单与重合度 | 第 5 节 |
全程在真实图上跑,没有替换成合成图。
2. 数据:真的是哪一部分,模拟的是哪一部分
真实的部分
soc-redditHyperlinks-body.tsv,sha256 9bbf5751…8f4bfb5,286562 条 subreddit 间超链接, 2013-12-31 至 2017-04-30,每条带秒级时间戳和一个 ±1 的敌意标记(LINK_SENTIMENT,由原论文 的文本分类器给出)。匿名 curl 直接下载,无需注册、无需 API key、无需 DUA。
本轮的子图构建规则在任何实验之前固定,且与实验结果无关:
- 节点 = 全时段关联敌意边条数最多的 250 个 subreddit(并列按名字升序),再取训练期诱导子图 的最大连通分量 → 247 个节点。用敌意边而不是总活跃度选点,是因为要的是极化话题子图, 而敌意边是这个数据集自带的冲突信号。
- 边 = 两端都在节点集内的全部超链接,44623 条,其中 8040 条敌意边(18.0%),保留真实 时间戳与符号。窗内严格按真实时间戳次序处理。
- 时间窗 = 自然月,2014-01..2017-04 共 40 窗(2013-12 只有 1 天,丢弃)。
- 前 24 窗(2014-01..2015-12)训练,后 16 窗(2016-01..2017-04,17434 条边)整段留出。
模拟的部分,以及为什么必须模拟
这个数据集不含任何节点观点标签。我们先试了能不能从它自己的符号结构里把「两大阵营」的立场轴 提出来,结论是不能,而且有明确证据:
- 归一化有符号拉普拉斯的最小特征值是 0.055,离 0 还远 —— 这张图远不是结构平衡的, 不存在一个把敌意边基本切干净的两阵营划分。
- 强行取主特征向量的话,它基本由节点度数主导:247 个节点里只有 3 个落在另一侧。
所以我们不伪造立场轴。意见 x_i ∈ [−1,1] 是定义在真实图上的受控状态变量, 规则在 claims.json 里跑前写死:
- 窗内按真实时间戳逐条处理边 (u→v, 符号 σ):
x_v ← clip(x_v + 0.1·σ·(x_u − x_v), −1, 1)—— 正边同化、敌意边排斥。 - 窗末做 Friedkin–Johnsen 锚定与噪声:
x ← clip(0.9·x + 0.1·s + ε, −1, 1),ε~N(0, 0.01²)。 - 内在意见 s_i = x_i(0) ~ Uniform(−1,1),由种子决定。
- 极化 P(t) = 全体节点意见的总体方差 Var(x),即「极化方差」。
初值取随机而不是人工设计,是为了让极化结构完全由真实的敌意边与真实时序产生, 而不是由我们预先摆好的两个阵营产生。代价写在第 0 节:本轮的意见值不对应任何真实立场。
真实的敌意结构确实在起作用,不是摆设。我们跑了图零模型:保持拓扑、时间戳次序、正负边总数 完全不变,只把全部边的 ±1 符号全局随机置换,结果零模型臂的留出期末极化方差从 0.1226 降到 0.1141(12/12 种子,p = 0.00049)。也就是说,真实敌意边落在哪些边上,本身就额外支撑了 约 7% 的极化水平;换成随机符号,同一张图撑不住这么高的极化。
3. 方法
环境与预算
每个留出窗开始时,策略选一个节点集合 A_t(|A_t| ≤ b = 12,占 247 个节点的 4.86%, 满足「受控节点 ≤ 5%」的设定),对 i ∈ A_t 执行 x_i ← 0.5·x_i,把该节点当前表达拉向中性 一半。扰动只作用于表达意见,不改内在意见,所以效果会在 FJ 锚定下逐窗衰减 —— 这正是「何时花预算」成为一个真问题的原因。
全部干预臂共享同一总预算 B = 12 × 16 / 2 = 96 次「节点×窗」动作,等价于「只能在一半的月份里 满额出手」。逐臂实际花费全部核对过:8 个臂每个种子都恰好花满声明预算,无一超支(第 6 节)。
臂
| 臂 | 类型 | 说明 | ||
|---|---|---|---|---|
null_no_intervention | 零模型 | 完全不干预,花费 0。所有降幅的参照系 | ||
random_budget_matched | 平凡基线 | 隔月随机挑 12 个节点 | ||
degree_top_b | 平凡基线 | 度中心性优先(传统启发式) | ||
extremity_top_b | 主对照 | 挑当前 \ | x_i\ | 最大的 12 个节点 |
extremity_double_budget | 正对照 | 同上但预算翻倍(192) | ||
offline_rl_fqi | 实验臂 | 离线 Fitted Q Iteration |
把 extremity_top_b 定为主对照不是随便挑的:对方差这个目标,单步扰动的收益恰好是 (1−(1−η)²)·x_i²,所以挑最极端的节点是可证明的单步最优。离线 RL 唯一可能赢的地方, 只剩长程效应和出手时机 —— 这一点在跑之前就写进了预注册。
离线强化学习
Fitted Q Iteration(Ernst et al., JMLR 2005)+ ExtraTrees 函数逼近。离线的含义是严格的: 行为策略(50% 随机 + 50% 极端度贪心)在训练期 8 个种子 × 3 次回放上一次性采出 142272 条转移,采完即冻结;FQI 的 5 轮迭代全部是在这个固定数据集上做回归, 学习过程中一次都没有与环境交互。训练日志一条都不来自留出期。
- 12 维特征,全部只用决策时刻可观测的量:当前意见、内在意见、上一窗的度/敌意度/邻居意见/ 局部分歧、剩余预算比例、剩余时程、当前总体方差。不含任何未来信息。
- 逐节点奖励 r_i = (x_i(t)² − x_i(t+1)²)/N —— 极化方差里均方项的逐节点精确分解。 这是一个已声明的信用分配近似(丢掉了 −x̄² 项);评估时用的是完整的 Var(x),不用这个近似量。
- γ = 0.9,5 轮迭代,ExtraTrees 300 棵树、min_samples_leaf=20。超参是跑前锁定的那一组, 没做任何搜索,只跑过这一组。
- 评估时策略冻结,按优势 Q(φ,1) − Q(φ,0) > 0 选 top-b,受同一总预算约束。
留出协议与配对
两层留出同时成立:训练窗口与评估窗口不相交(2015-12 之前 / 2016-01 之后), 训练种子与评估种子不相交(1-8 / 101-112)。
配对方式:每个评估种子先用「完全不干预」从 2014-01 热身到 2015-12 末,得到该种子的留出期起点; 所有臂从同一个起点、在同一套真实边流、同一条噪声序列上跑留出期 16 窗。 因此臂之间可以做配对检验,臂间差异不含起点差异。
4. 结果
极化方差降低幅度(主指标)
留出期末(2017-04)的极化方差,12 个评估种子的中位数:
| 臂 | 极化方差 P_end | 相对零模型降幅 | 预算 | 实际花费 |
|---|---|---|---|---|
| 零模型(不干预) | 0.12263 | — | 0 | 0 |
| 度中心性优先 | 0.11878 | +2.89% | 96 | 96 |
| 随机(预算匹配) | 0.11060 | +10.72% | 96 | 96 |
| 离线强化学习 FQI | 0.10384 | +15.87% | 96 | 96 |
| 极端度贪心(主对照) | 0.07897 | +34.99% | 96 | 96 |
| 极端度贪心·预算翻倍(正对照) | 0.06310 | +48.88% | 192 | 192 |
图:figs/polarization_trajectories.png(16 个月的完整轨迹)、 figs/reduction_vs_null.png(逐种子降幅)。
预注册假设的判定
| 假设 | 判定 | 计数 | 配对差值中位数 | 配对 Wilcoxon 双侧精确 p | rank-biserial |
|---|---|---|---|---|---|
| H1 主对照:RL 优于极端度贪心(终点) | 推翻 | 0/12 | −0.02508 | 0.00049 | −1.00 |
| H1 次要:RL 优于极端度贪心(全程 AUC) | 推翻 | 0/12 | −0.00164 | 0.00049 | −1.00 |
| H2 零模型:随机 优于 不干预 | 成立 | 12/12 | +0.01292 | 0.00049 | +1.00 |
| H2 零模型:度中心性 优于 不干预 | 成立 | 12/12 | +0.00384 | 0.00049 | +1.00 |
| H2 零模型:极端度贪心 优于 不干预 | 成立 | 12/12 | +0.04334 | 0.00049 | +1.00 |
| H2 零模型:离线 RL 优于 不干预 | 成立 | 12/12 | +0.02043 | 0.00049 | +1.00 |
| H3 正对照:预算翻倍 优于 单倍 | 成立 | 12/12 | +0.01688 | 0.00049 | +1.00 |
| H4 负对照:两个随机变体无差异 | 成立 | 6/12 | +0.00023 | 0.73340 | +0.13 |
每一条计数式说法(「N/12 个种子」)旁边都并列给出了配对 p 值、配对差值中位数与效应量, 这是预注册里写死的报告要求。n=12 的配对 Wilcoxon 精确检验,双侧 p 的下限是 2/2¹² = 0.00049, 上表里几个 0.00049 都已经顶到这个下限,即「12 个种子全部同向」在这个检验下能给出的最强证据。
图:figs/primary_paired_difference.png(主对照逐种子配对差值)。
5. 策略轨迹报告
图:figs/policy_trajectory.png · 数据:work/results/policy_trajectory.json
出手时机 —— 这就是输的地方
| 离线 RL | 极端度贪心 | |
|---|---|---|
| 出手的月份 | 留出期第 1–8 月,连续满额 | 第 1,3,5,7,9,11,13,15 月,隔月满额 |
| 出手月份数 | 8 | 8 |
| 每次出手节点数 | 12 | 12 |
| 总花费 | 96 / 96 | 96 / 96 |
| 碰过的不同节点数 | 201 | 156 |
| 与对方选中节点的重合度 | 81.8% | — |
两者花的钱一样多、出手的月份数一样多、选的节点还有 81.8% 重合。唯一的实质差别是 把预算摊在哪些月份:离线 RL 全压在前半程,贪心摊满全程。
机制(事后探索,非预注册,不参与任何判据)
数据:work/results/exploratory_post_hoc.json
| 阶段 | 离线 RL 平均极化 | 极端度贪心 平均极化 | RL 更低的种子数 |
|---|---|---|---|
| 第 1–8 月(RL 在花钱) | 0.0704 | 0.0798 | 12/12 |
| 第 9–16 月(RL 没钱了) | 0.0873 | 0.0746 | 0/12 |
离线 RL 在花钱的那 8 个月里确实更有效率 —— 连续满额出手把方差压得比隔月出手更低, 12 个种子无一例外。但扰动只作用于表达意见,会在 FJ 锚定下衰减;预算用光之后的 8 个月里 方差一路反弹,12 个种子无一例外地被贪心反超。终点和全程 AUC 两个口径上都输。
这正是离线 RL 的一个经典失败模式(Levine et al. 2020 综述第 4 节):价值函数在数据覆盖不到的 区域被高估,策略于是倾向于尽早、尽多地出手,把远期收益贴现掉。另有一个可以直接核对的实现层原因:`horizon_left_frac` 这个特征训练时以 24 窗为分母、评估时以 40 窗为分母,留出期第一窗的特征值只有 0.40,落在训练分布里「时程将尽」那一段——策略因此开局就按「快到期」的方式把预算花光。训练日志里 84.4% 的状态-动作对优势为正,也符合价值高估。这两个都是候选解释,不是已验证的机制:本轮没有把 RL 的选点固定到隔窗日程、没有核对 Q 值与实际回报、也没有把特征口径改齐重训。
被扰动最多的节点
离线 RL 累计扰动次数最高的是 clashofclans(26)、shitamericanssay(23)、aznidentity(23)、 skeptic(19)、civcraft(19);极端度贪心是 hearthstonecirclejerk(37)、aznidentity(31)、 clashofclans(25)、metanarchism(25)、shitgreeddisastersays(24)。完整前 20 名两份清单都在 work/results/policy_trajectory.json。注意:这些节点被选中是因为它们在模拟意见空间里数值 极端,不代表这些社区在现实中更极端。
6. 敌意复核:两项核心
① 这把尺子能不能测出已知的差距
正对照通过。 预算从 96 翻到 192,尺子测出来了:12/12 种子,配对差值中位数 +0.01688, p = 0.00049。方向已知的差距,尺子抓得住。
负对照通过。 两个只有内部随机数不同的随机策略互比:6/12,配对差值中位数 +0.00023, p = 0.73340,rank-biserial +0.13。不该有差异的地方,尺子没有虚报。
两项都过,所以 H1 被推翻不能赖到「测不出来」头上。
② 最要命的那个混杂:预算与起点不对齐
一个偷偷多花预算、或者从更低方差起点出发的臂会无条件赢。这是本轮设计里最容易翻车的地方, 事先用三条措施消掉,事后逐条核对过:
- 同一起点:每个种子的留出期起点由同一次无干预热身产生,全部臂共用。
- 同一随机性:全部臂在同一套真实边流、同一条噪声序列上跑。
- 预算是作废开关:逐臂逐种子记录实际花费。核对结果 —— 8 个臂在 12 个种子上全部恰好 花满声明预算,无一超支(
analysis.json的budget_accounting,audit_delivery.py会重算)。
本轮不做独立复算之外的第三方重跑;但头条数字本身走了两条独立实现: 主分析用 scipy(Python 3.12),复算用纯标准库对 2¹²=4096 种符号翻转做全枚举(Python 3.14, 不依赖 scipy/numpy)。两条路径的 p 值、配对差值中位数、效应量、计数全部一致, audit_delivery.py 每次跑都会重新比对。
其他已声明的混杂(跑前就写在 claims.json 里)
- 意见值是模拟的 —— 已在第 0、2 节展开。
- 分布漂移:训练 2014-01..2015-12,评估 2016-01..2017-04,Reddit 自身在变。RL 输了可能是 漂移而非方法,本轮拆不开。
- 信用分配近似:逐节点奖励丢掉了 −x̄² 项(评估指标本身不受影响)。
- 行为策略只有两种,离线 RL 的表现受日志覆盖度限制。
- subreddit 是社区不是人,节点级结论不能直接读成个体级结论。
degree_top_b拿到了一点信息优势:预注册原文写的是「当前窗内活跃度」,代码照预注册原文实现, 于是它看到了当前窗尚未发生的交互。我们没有回头改预注册(详见AMENDMENTS.md)。 这个不对称只让基线更强,且主对照extremity_top_b不含此优势,主结论不受影响; 实际上degree_top_b还是表现最差的干预臂。
7. 这个结果对下一步意味着什么
第一,问题出在预算的时间分配,不在节点选择。 两个策略选的节点 81.8% 重合,差别几乎全在 「哪几个月出手」。这把后续工作的范围收窄了很多:要让离线 RL 在这个设定里赢,得先让它学会等, 而不是换更大的网络或更多特征。
第二,几条具体的、有判据的下一步(按我们判断的性价比排序):
- 把预算约束显式写进状态与目标。现在 FQI 只在特征里放了「剩余预算比例」,价值函数没有被 强制满足预算守恒,所以它贪早。改成带预算维度的有限时程动态规划、或在奖励里对早花钱加惩罚, 是最直接的一刀。判据就用本轮同一套:能不能在留出期把配对差值的符号翻过来。
- 换扰动算子。本轮的扰动只改表达意见、会衰减,所以摊薄比集中好,贪心天然占便宜。 如果改成部分中和内在意见(效果不衰减),或者改成加/删边这类结构性干预, 长程规划的价值才有机会体现出来,RL 与贪心的差距结构会完全不同。
- 换成需要预测未来冲突的设定。真正能让 RL 拉开差距的,是那些「必须提前预判下个月哪里要爆」 的任务 —— 本轮数据集里每条边都带敌意标记和时间戳,完全支持把目标改成「在冲突爆发前抢先 干预」。这是我们看下来最有可能出现 RL 优势的方向。
- 保守派离线 RL(CQL / IQL 之类)压住价值高估。本轮观察到 84.4% 的状态-动作优势为正, 是典型的高估症状,这类方法就是为它设计的。
第三,本轮的负结果本身是有用的。 它把「在真实时变图上用离线 RL 做节点级去极化」这条路上 最省事的那个版本排除掉了,而且给出了排除的理由和位置。如果没跑这一轮, 上面第 1、2 条改动很可能会被当成「锦上添花」而不是「必须先解决的问题」。
8. 怎么复现
``bash bash work/code/00_download_data.sh ./raw # 匿名下载 SNAP 原始文件 python work/code/01_build_temporal_graph.py ./raw work/data python work/code/03_offline_rl.py # 离线 FQI 训练,约 220 秒 python work/code/04_evaluate.py # 留出期评估,约 49 秒 python work/code/05_analyze.py # 主分析(需 scipy) python3 work/code/06_recheck.py # 独立复算(纯标准库) python work/code/07_figs.py # 出图 + 策略轨迹报告 python3 audit_delivery.py # 包内自检 ``
依赖:numpy、scipy、scikit-learn、matplotlib(05/07 需要);06_recheck.py 与 audit_delivery.py 只用标准库。全部随机性都由显式种子控制,同机重跑逐位可复现。
figs/ 目录。随附材料(点开即看,不用下载)
- results.json原始结果。报告里每个数字都能在这里查到
- plan.json事先写下的实验计划与那个可被推翻的预测(预注册)
- REPORT.md本页的 markdown 原文
- 00_download_data.sh实验代码 00_download_data.sh
- 01_build_temporal_graph.py实验代码 01_build_temporal_graph.py
- 03_offline_rl.py实验代码 03_offline_rl.py
- 04_evaluate.py实验代码 04_evaluate.py
- 05_analyze.py实验代码 05_analyze.py
- 06_recheck.py实验代码 06_recheck.py
- 07_figs.py实验代码 07_figs.py
- 08_posthoc_descriptive.py实验代码 08_posthoc_descriptive.py
- 09_manifest.py实验代码 09_manifest.py
- 10_page_artifacts.py实验代码 10_page_artifacts.py
- env_depolarization.py实验代码 env_depolarization.py
- fig.png主结果图
← 全部案例 · JouleBeat · DeepGraph