痛风到心血管的知识图谱扩散:全局信号是真的,但顶端那 50 个基因没有效力
0. 结论
一句话:痛风的知识图谱里确实有一个统计上站得住的、指向心血管基因的信号,但它小到不足以支撑一张可用的 top 50 预测名单。名单照给,但它是线索表,不是预测表。
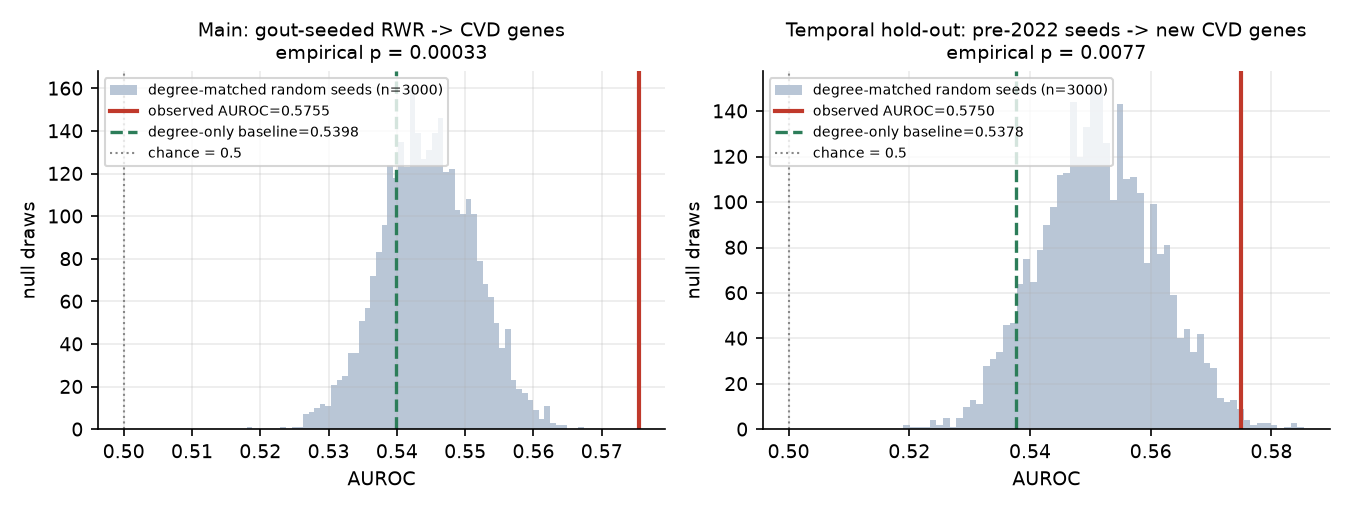
第一层,信号是真的。 以 256 个痛风 GWAS 基因为种子在 STRING 蛋白互作网络上做扩散,判别「这个基因是否已被 GWAS 报道过与心血管疾病关联」的 AUROC = 0.5755;度数配对零模型(3000 组「网络位置一样、但与痛风无关」的种子)均值 0.5446,3000 次没有一次达到实测值,经验 p = 0.00033(z = 4.56)。五折留出配对检验 15 折全部胜出,AUROC 增益中位数 +0.0292(自助法 95% 区间 [0.0236, 0.0311]),精确 Wilcoxon 双侧 p = 6.1e-05。只用 2021 年底前已知的 37 个痛风基因、预测 2022 年之后才首次被报道的心血管基因,AUROC 仍有 0.5750(经验 p = 0.0077)——这一条已经撤回。 交付后把网络冻结到 2021 年发布的 STRING v11.5 重跑:AUROC 掉到 0.5620,零模型 0.5535 ± 0.0088,经验 p = 0.174(z = 0.97),不再显著。而在未冻结的 v12.0 上只用同样这 34 个种子仍然显著(p = 0.0113),所以信号消失不是因为少了 3 个种子,而是它依赖 2022 年之后才进入网络的内容——另外标签这一侧同样不是历史快照(用的是 2026 年的 GWAS Catalog,“首次报道年份”“本体项归属”“最近基因映射”都是 2026 年回溯策展的结果),所以两头都不满足前瞻的要求——标签按时间切了、特征没切,原来那个 p = 0.0077 撑不起「前瞻性验证」这个名字。全部数字见交付包内的冻结重跑说明。
第二层,信号很弱,弱到 top 50 用不了。 AUROC 距离随机只有 0.0755。top 50 里已知心血管基因 3 个,命中率 6.0%,零模型 4.24%,经验 p = 0.35——不显著。k 从 10 扫到 500,没有任何一档能与零模型区分(最好一档 p = 0.10)。这套方法能把整条排序整体往正确方向拨一点,但拨不动最顶端。
第三层,为什么可以相信上面两句话。 三个对照都通过:
- 负对照:标签随机打乱 3000 次,AUROC 均值 0.49987,95% 区间 [0.4788, 0.5204],盖住 0.5。
- 正对照:「用 4/5 痛风基因预测留出的 1/5」AUROC 0.6387,比零模型高 +0.0899——是跨病种信号(+0.0309)的约 3 倍。要说清楚的是:正对照跑在不同的评估宇宙、不同的阳性集上(留出约 51 个痛风基因 vs 756 个心血管阳性),所以它证明的是「同病种任务上这套工具有效」,不能直接当作跨病种任务的灵敏度或功效证明。
- 去文献通道:STRING 的 textmining 分数与心血管标签来自同一批文献,是最直接的循环论证风险。拿掉 textmining 重建网络,AUROC 降到 0.5431,零模型 0.5224,经验 p = 0.0127。信号缩水约三分之一但没有消失——不是纯粹的文献共现假象,但有一部分是。
这一轮不能支持的推断
- 不能对任何病人说任何话。 本轮没有病人层面的数据,不回答风险分层或诊疗问题。
- top 50 不能当作「预测出来的致病基因」用,其命中率与零模型没有统计差异。
- 不能说这些基因与心血管并发症有因果关系。 GWAS 基因映射是「离 SNP 最近的基因」,本轮没做精细定位、没做孟德尔随机化。
- 不能外推到东亚人群。 GWAS Catalog 以欧洲祖源为主,痛风的遗传结构在东亚人群里明显不同(ABCG2 就是典型)。
- 不区分心血管并发症的具体类型:冠心病、心衰、卒中、外周动脉疾病被压成同一个标签。
1. 问题为什么落在基因层面
「痛风病人是否发生心血管并发症」的病人层面二分类,需要带随访结局的个体数据(UK Biobank、CPRD、医院电子病历),这些全部是申请制,超出「只用匿名可下载公开数据」的边界。本轮不绕行,而是把二分类下沉到基因层面:
| 病人层面的问题 | 本轮实际做的 | |
|---|---|---|
| 分类对象 | 一个痛风病人 | 一个基因 |
| 标签 y=1 | 发生了心血管并发症 | 该基因是心血管疾病 GWAS 关联基因 |
| 预测信息 | 临床与基因型 | 痛风基因在蛋白互作网络上的邻域 |
| 回答的问题 | 谁会发病 | 痛风的分子网络本身能不能指认出心血管基因 |
如果痛风的网络结构连"哪些基因是心血管基因"都指不出来,那么"网络上离痛风最近的 50 个基因"就没有预测效力背书。先检验它,再给表。
2. 数据与方法
2.1 数据(两个公开库,匿名可下载)
- GWAS Catalog(EBI,2026-09-04 发布版):全量 1192032 条关联。
- STRING v12.0 人类蛋白互作网络(9606)。
抽取规则跑前写死在 claims.json:
- 只取 P < 5e-8;只取落在基因内部的 SNP(基因间 SNP 归属有歧义,丢弃);
- 痛风种子:
MONDO_0005393(gout)与EFO_0021525;刻意不含EFO_0004531(尿酸水平不等于痛风); - 心血管标签:11 个疾病本体项(只要疾病,不要测量指标);
- 基因符号到 STRING 只做精确匹配。
映射进 STRING 后:痛风种子 256 个、心血管阳性 828 个、重叠 72 个。
> DisGeNET 原计划作补充来源,实测其下载地址已跳转到登录页、不能匿名下载,按边界弃用,改为直接用 GWAS Catalog 原始关联自行映射。
2.2 网络与打分
STRING combined_score >= 700,16201 个节点、236930 条边。重启随机游走(RWR),种子均匀分布在 256 个痛风基因上,alpha = 0.3(跑前定死,全程不调)。
防泄漏:256 个痛风种子整体从评估宇宙中剔除,否则 72 个重叠基因会天然拿到最高分。剔除后评估宇宙 15945 个基因,心血管阳性 756 个(基线阳性率 4.741%)。
2.3 对照臂
| 臂 | 类型 | 回答什么 |
|---|---|---|
gout_rwr | 实验臂 | 痛风种子的网络扩散分数 |
degree_only | 平凡基线 | 只看连边数,完全不看痛风——研究偏倚的化身 |
degree_matched_random_seeds | 零模型 | 3000 组度数逐个配对、与痛风无关的种子 |
label_permutation | 负对照 | 标签打乱后 AUROC 应回到 0.5 |
positive_control_gout_self | 正对照 | 痛风预测留出痛风;测不出说明尺子坏了 |
随机种子 20260912 / 20260913 / 20260914,按种子分别报告,不挑种子。
3. 结果
3.1 尺子是好的
| 检验 | 结果 | 判定 |
|---|---|---|
| 标签置换 3000 次 | 均值 0.49987,95% 区间 [0.4788, 0.5204] | 通过 |
| 正对照(15 折) | AUROC 0.6387 vs 零模型 0.5494 | 通过 |
| 正对照增益 | 中位 +0.0899,15/15,Wilcoxon p = 6.1e-05,自助法 95% 区间 [0.0805, 0.0980] | 通过 |
3.2 主判据:信号真实,但很小
| 指标 | gout_rwr | degree_only | 度数配对零模型 |
|---|---|---|---|
| AUROC | 0.5755 | 0.5398 | 0.5446 ± 0.0068 |
| AUPRC | 0.0585 | 0.0510 | —(基线 0.0474) |
| 经验 p | 0.00033 | — | — |
| 配对比较(15 折) | 胜负 | 增益中位数 | 自助法 95% 区间 | Wilcoxon p |
|---|---|---|---|---|
| vs 度数配对随机种子 | 15/15 | +0.0292 | [0.0236, 0.0311] | 6.1e-05 |
| vs 只用度数 | 15/15 | +0.0356 | [0.0347, 0.0369] | 6.1e-05 |
15 折全赢,但每折只赢约 0.03 个 AUROC——计数式说法必须和连续量一起读。
3.3 时间留出(原结论已撤回:冻结网络后不显著)
2021 年底前 37 个痛风基因当种子,预测 2022 年起首次报道的心血管基因(评估宇宙 15523 个、334 个新阳性):AUROC 0.5750,度数基线 0.5378,零模型 0.5514 ± 0.0098,经验 p = 0.0077。种子只有 37 个,功效有限。
3.4 去掉文献通道
| 指标 | 全通道 | 去掉 textmining |
|---|---|---|
| AUROC | 0.5755 | 0.5431 |
| 零模型均值 | 0.5446 | 0.5224 |
| 相对零模型增益 | +0.0309 | +0.0207 |
| 经验 p | 0.00033 | 0.0127 |
3.5 最重要的否定性结果:top 50 那一段没有效力
| top-k | 命中率 | 命中数 | 零模型均值 | 经验 p |
|---|---|---|---|---|
| 10 | 10.0% | 1/10 | 2.93% | 0.25 |
| 20 | 5.0% | 1/20 | 3.53% | 0.50 |
| 50 | 6.0% | 3/50 | 4.24% | 0.35 |
| 100 | 6.0% | 6/100 | 4.58% | 0.32 |
| 200 | 7.0% | 14/200 | 4.92% | 0.11 |
| 500 | 6.4% | 32/500 | 5.05% | 0.10 |
全局 AUROC 显著而顶端不显著,并不矛盾:AUROC 是整条排序的平均性质,可以被中段和尾段撑起来。度数校正排序(专门压 hub 效应)也没有更好:precision@50 降到 4.0%(p = 0.62)。排序方式不是瓶颈(度数校正也没更好);我们判断瓶颈在数据层,但本轮没做功效/可识别性分析——top 50 这个设计期望命中只有约 2.1 个、实测 3 个,这种量级本来就测不出差异,所以这是判断,不是已证实的结论。
top 50 的成分也说明问题:既有 TP53、EGFR、CTNNB1 这样的超级枢纽,也有紧贴某个痛风基因而上榜的低度数基因;中位度数排名 242 / 16201,整体偏向被研究得多的基因。
4. 产出:top 50 候选基因与证据链(基因层面的线索表,不是病人层面的风险预测)
完整表在 work/results/top50_candidates.tsv 与 top50_candidates.json(含到痛风种子的最强路径与每条边的 STRING 分数)。它是"网络上离痛风最近、值得人工过一眼的 50 个基因",不是"预测出来的共病基因"。
| 排名 | 基因 | RWR 分数 | 度数排名 | 已知心血管基因 | 最强证据链(STRING 分数) |
|---|---|---|---|---|---|
| 1 | TP53 | 1.170e-3 | 1 | 否 | TP53 → CHEK2 (999) |
| 2 | TMEM192 | 1.104e-3 | 13944 | 否 | TMEM192 → SPRYD4 (820) |
| 3 | PTP4A1 | 1.074e-3 | 8963 | 否 | PTP4A1 → CNNM2 (970) |
| 4 | EGFR | 1.029e-3 | 4 | 否 | EGFR → PTPN11 (999) |
| 5 | HDAC1 | 9.554e-4 | 45 | 否 | HDAC1 → EZH2 (999) |
| 6 | UBE2D2 | 9.459e-4 | 921 | 否 | UBE2D2 → RNF115 (801) |
| 7 | SDCBP | 9.313e-4 | 3007 | 否 | SDCBP → NRXN2 (826) |
| 8 | CCDC63 | 9.229e-4 | 11701 | 否 | CCDC63 → HECTD4 (700) |
| 9 | CBFA2T3 | 9.119e-4 | 6424 | 否 | CBFA2T3 → ZNF652 (827) |
| 10 | MAGI3 | 9.059e-4 | 8658 | 是(2022) | MAGI3 → MAST3 (763) |
50 个里有 3 个(MAGI3、RHOA、ERBB2)已带心血管 GWAS 关联——是对排序的支持性检查,不是新发现。
另附 72 个在 GWAS Catalog 中同时带痛风与心血管关联的基因(known_gout_cvd_overlap):已知事实表,不是预测,但作为有双重 GWAS 证据的起点可能比 top 50 更直接可用。
5. 已声明的限制(跑前写在 claims.json 里)
- 研究偏倚 / hub 偏倚:用平凡基线和度数配对零模型正面对冲,实验臂都赢了,但 top 50 的成分说明偏倚没被完全消掉。要补一句:零模型只配对了网络度数,没有直接配对“这个基因被研究了多少”(文献量、被引),而去掉 textmining 通道后信号缩水约三分之一,正说明文献成分确实在里面。
- 文献循环证据:去 textmining 后信号缩水三分之一但仍在;实验通道本身也有研究偏倚,控制不彻底。
- GWAS 基因映射不等于因果基因。
- 心血管阳性集高度异质(11 个本体项压成一个标签)。
- 人群可迁移性未检验。
- 时间留出功效有限(种子 37 个);而且这一条已撤回——特征网络没冻结到切点,冻结到 STRING v11.5 后 p = 0.174,不再显著。
- 不回答任何病人层面的问题。
6. 如果继续,往哪走
- 在"公开 GWAS + 公开互作网络"这一层堆更复杂的图算法,回报很可能有限——瓶颈在数据层。
- 同病种信号远强于跨病种(+0.0899 vs +0.0309);若目标是痛风本身的候选基因,这条路效力好得多。
- 跨病种共病缺的是连接两端的中间层:共享表达调控、代谢通路(尿酸—NLRP3 炎症小体)、或带结局的队列数据。
- 72 个双重 GWAS 证据的重叠基因,是眼下最实在的起点。
7. 怎么复现
全部代码、数据抽取结果、日志、图在 work/ 下。python3 audit_delivery.py 用一条独立的纯标准库实现重算报告里的每个数字,对不上会报错退出。
figs/ 目录。随附材料(点开即看,不用下载)
- results.json原始结果。报告里每个数字都能在这里查到
- plan.json事先写下的实验计划与那个可被推翻的预测(预注册)
- REPORT.md本页的 markdown 原文
- 01_build_gene_sets.py实验代码 01_build_gene_sets.py
- 02_build_network.py实验代码 02_build_network.py
- 03_score.py实验代码 03_score.py
- 04_sensitivity_channels.py实验代码 04_sensitivity_channels.py
- 05_top50_evidence.py实验代码 05_top50_evidence.py
- 06_stats.py实验代码 06_stats.py
- 07_topk_precision.py实验代码 07_topk_precision.py
- 08_dump_for_audit.py实验代码 08_dump_for_audit.py
- 09_figures.py实验代码 09_figures.py
- 10_temporal_frozen_v115.py实验代码 10_temporal_frozen_v115.py
- fig.png主结果图
- 时间留出那一条已撤回:标签按报道时间切分,但特征网络未冻结到切点;冻结到 2021 年的 STRING v11.5 后 AUROC 0.5620、经验 p = 0.174,不再显著(同一组 34 个种子在未冻结网络上仍显著,p = 0.0113,所以不是种子数造成的)。
- 五折留出的 15 折不是 15 个独立观测(5 折 × 3 个种子,共用 80% 种子);「vs 只用度数」那一行的比较对象在 15 折里是同一个常数,其 p 值等价于单样本符号检验的下限,不能当额外证据。
- 病人层面的「痛风病人是否发生心血管并发症」需要带随访结局的个体数据(申请制 / 需数据使用协议),超出只用公开数据的边界。本轮改为基因层面的二分类,这一改动在跑之前写进预注册。
- 最重要的结论是否定性的:top 50 那一段的命中率(6.0%)与度数配对零模型(4.24%)没有统计差异,经验 p=0.35;k 从 10 扫到 500 没有任何一档显著。候选表只能当线索用,不能当预测靶点用。
- 试过专门压 hub 效应的度数校正排序,precision@50 反而降到 4.0%(p=0.62)——瓶颈在数据层不在排序方式。
- STRING 的 textmining 通道与 GWAS 标签共享同一批文献,构成循环证据。剔除该通道后 AUROC 从 0.5755 降到 0.5431(零模型 0.5224,p=0.0127),信号缩水约三分之一但未消失;这条控制并不彻底。
- GWAS 的 MAPPED_GENE 是位置最近的基因,不是因果基因;本轮未做精细定位或因果推断。
- 11 个心血管疾病本体项被压成一个标签(冠心病/心衰/卒中/外周动脉疾病),换样本量、损失表型分辨率。
- GWAS Catalog 以欧洲祖源样本为主,对东亚人群的可迁移性本轮未检验。
- DisGeNET 实测已不能匿名下载(跳登录页),按边界弃用。
← 全部案例 · JouleBeat · DeepGraph